Laboratório · IA · 2026
Teste às cegas
O que muda numa pesquisa quando ela é desenhada com game design.
Ouça este texto
Ato I · Por quê
O essencial
Plano de governo é um assunto que quase ninguém tem vontade de ler. Mesmo assim, 29 pessoas responderam pelo menos a primeira parte de um teste sobre os planos de 2026, e 13 foram até o fim. Este estudo conta o que muda numa pesquisa quando ela é desenhada com game design e construída com IA: o que faz alguém largar no meio, o que faz seguir e como desenhar para que até quem para no meio entregue dado útil.
Foi um teste pequeno, de propósito: um piloto para medir o engajamento das pessoas e ver se esse formato de pesquisa vale um teste com um público maior. Junto, uma segunda pergunta: com IA, até onde dá para explorar possibilidades assim em UX Research?
O teste é simples de explicar. As propostas dos dois planos aparecem em cards, sem o nome de quem propôs. A pessoa desliza para dizer se gostou, e só no fim descobre com qual plano tem mais afinidade.
Sem o nome do candidato, a pessoa lê a proposta em vez de defender um lado.
Quatro etapas curtas, como as faixas de um esporte de luta, e o lado revelado só no fim.
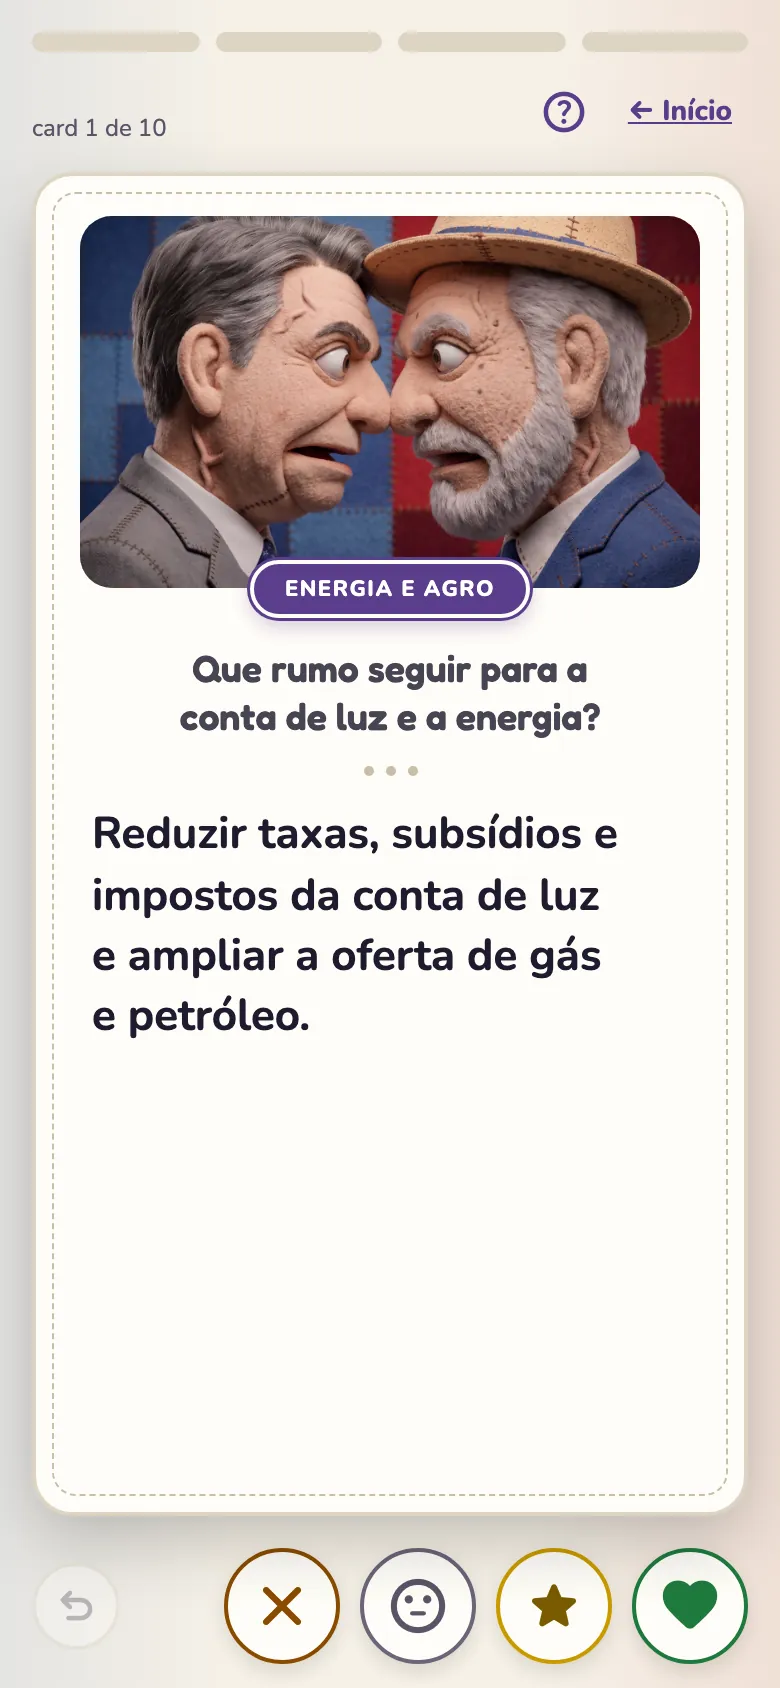
Uma proposta por vez e um gesto por resposta, no estilo do Tinder.
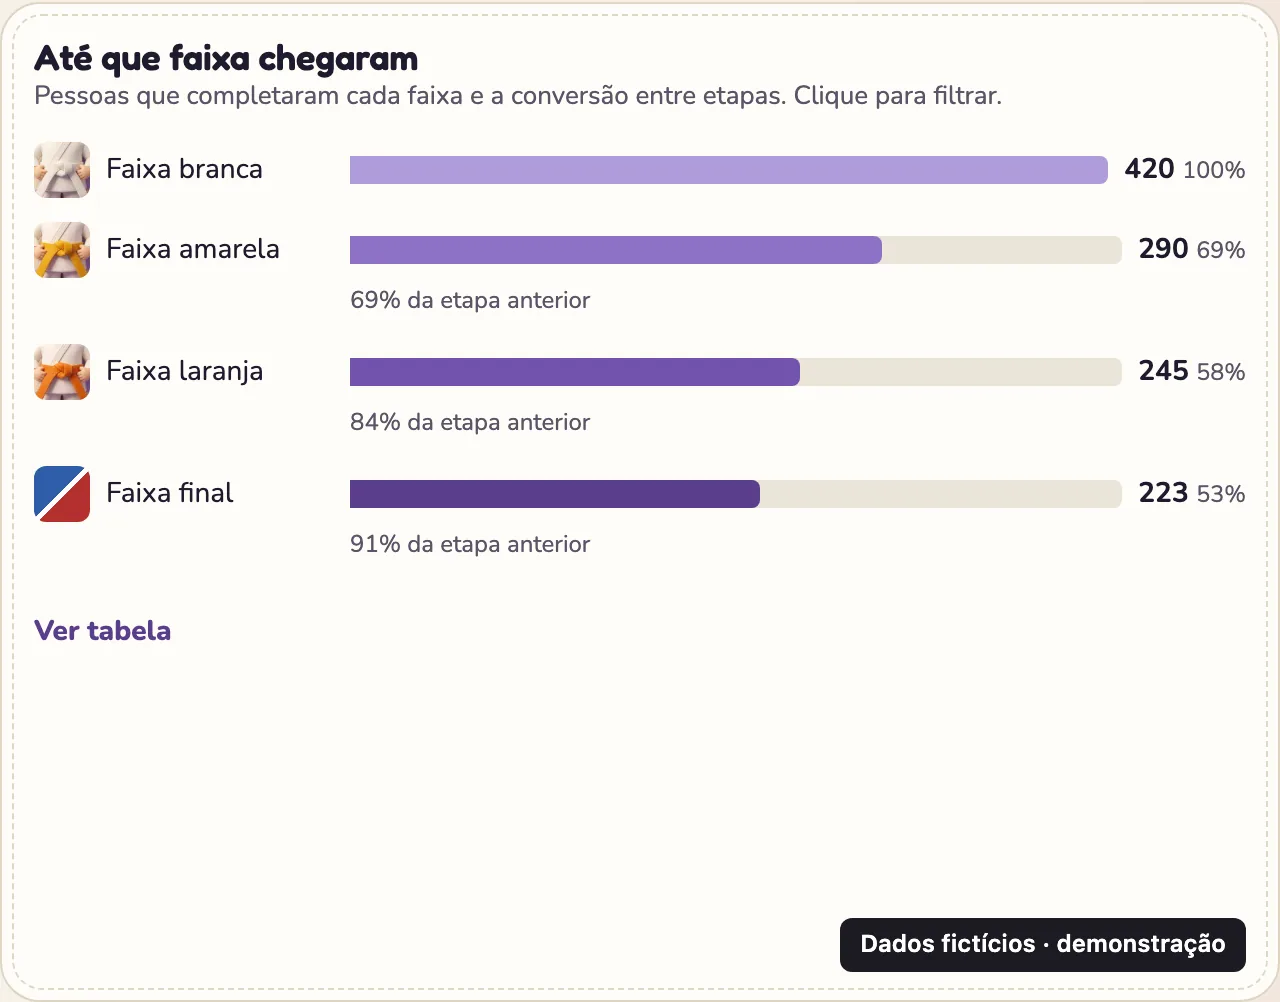
As respostas chegam ao fim de cada faixa, e as gravações do Clarity mostram onde a pessoa trava.
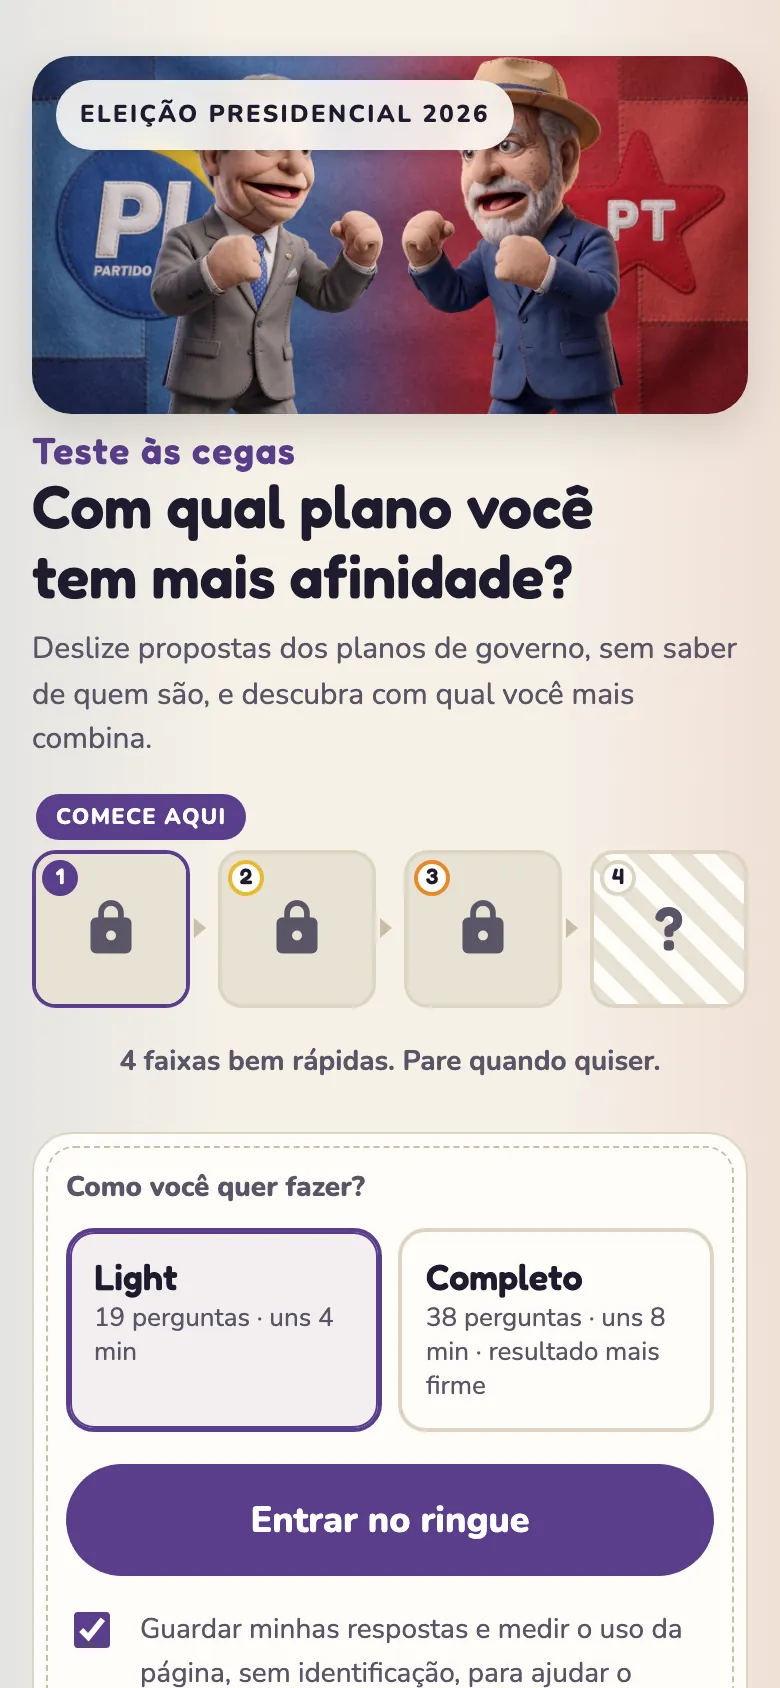
- 01As propostas, sem saber de quem são
- 02Quatro faixas, e o lado só no fim
- 03Light ou Completo: a pessoa escolhe
- 04Entrar no ringue
De onde veio a pergunta
O desafio nasceu numa reunião com o time da Digigroup, sobre atendimento a instituições governamentais. A gente estava falando de pesquisas que poderíamos fazer e, conversando com membros de câmaras municipais, apareceu um problema: as pesquisas internas têm baixo engajamento da população. Para algumas câmaras, isso vai ser uma das pautas de 2027.
Com isso como premissa, olhamos para as entrevistas que vinham aparecendo nas manifestações populares. Muitos entrevistados não sabiam defender o plano de governo do próprio candidato. Daí veio a pergunta que virou o teste: se as pessoas conhecessem os planos de governo, para quem elas votariam?
Antes de construir, a gente pensou no que daria para tirar das respostas, e para quem. O teste e o painel foram desenhados a partir disso. Os resultados políticos ficam fora deste estudo; a tabela mostra só que tipo de leitura cada um ganha.
| Para quem | O que os resultados entregam | Onde isso está no teste |
|---|---|---|
| Quem responde | Com qual plano tem mais afinidade, onde diverge do próprio lado, o quanto pende e quanto marcou tanto faz | O resultado: o perfil, os medidores e o cartão de compartilhar |
| Câmaras e instituições do governo | Que pautas a população aprova ou rejeita, quais temas dividem mais e quanta gente se engaja numa pesquisa desenhada assim | No painel, as páginas Pautas e Propostas, e o funil por faixa |
| Campanhas e partidos | Que propostas reforçar com a própria base, quais conquistam indecisos, quais defender ou reformular e onde o rival está fraco | No painel, a página Candidatos, com as quatro listas |
| Quem faz pesquisa | Um jeito de medir opinião com mais engajamento, e dado útil mesmo de quem para no meio | As faixas, o Light e o Completo, o tutorial e o Clarity |
A mecânica veio da Estaff
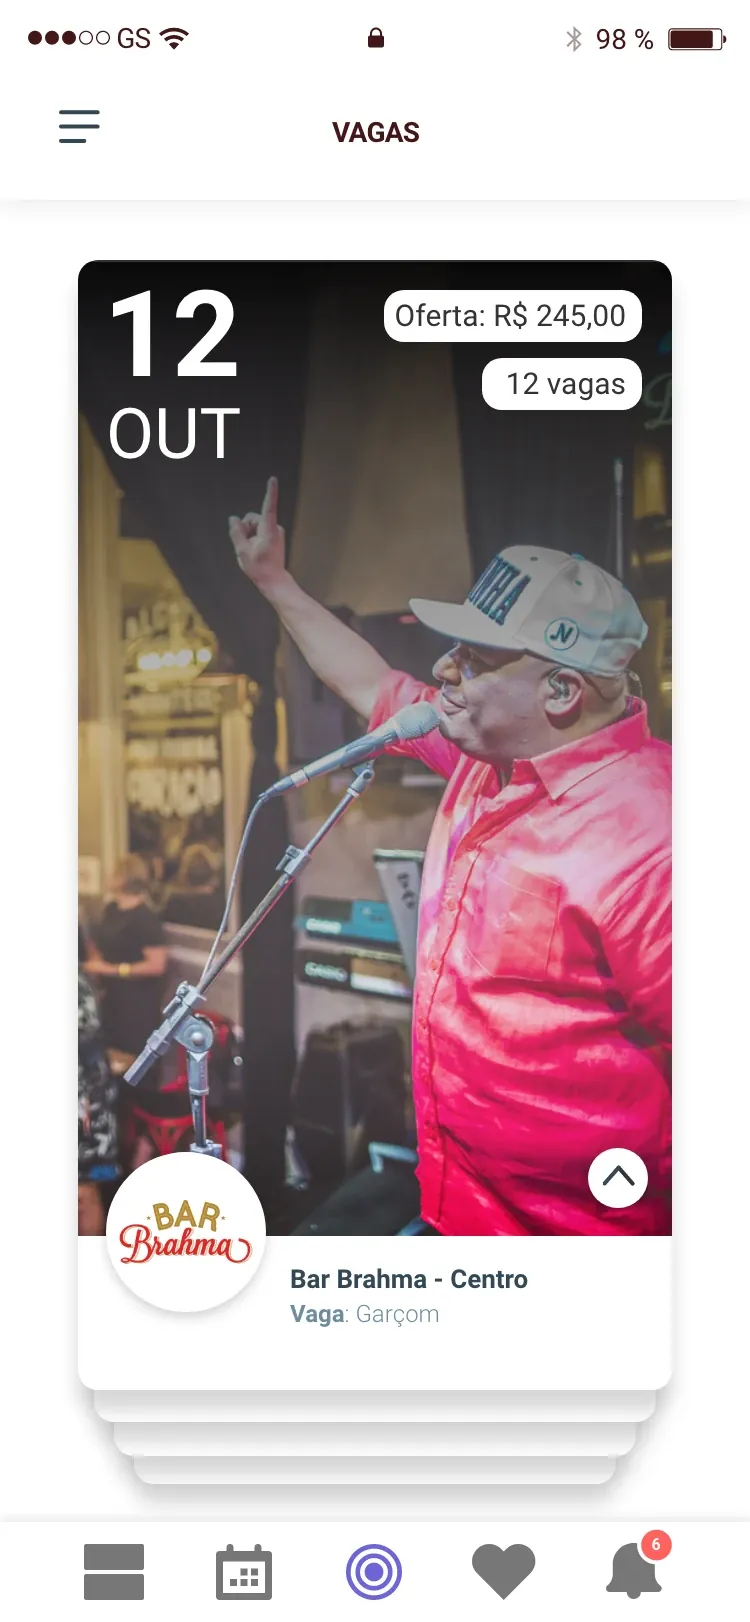
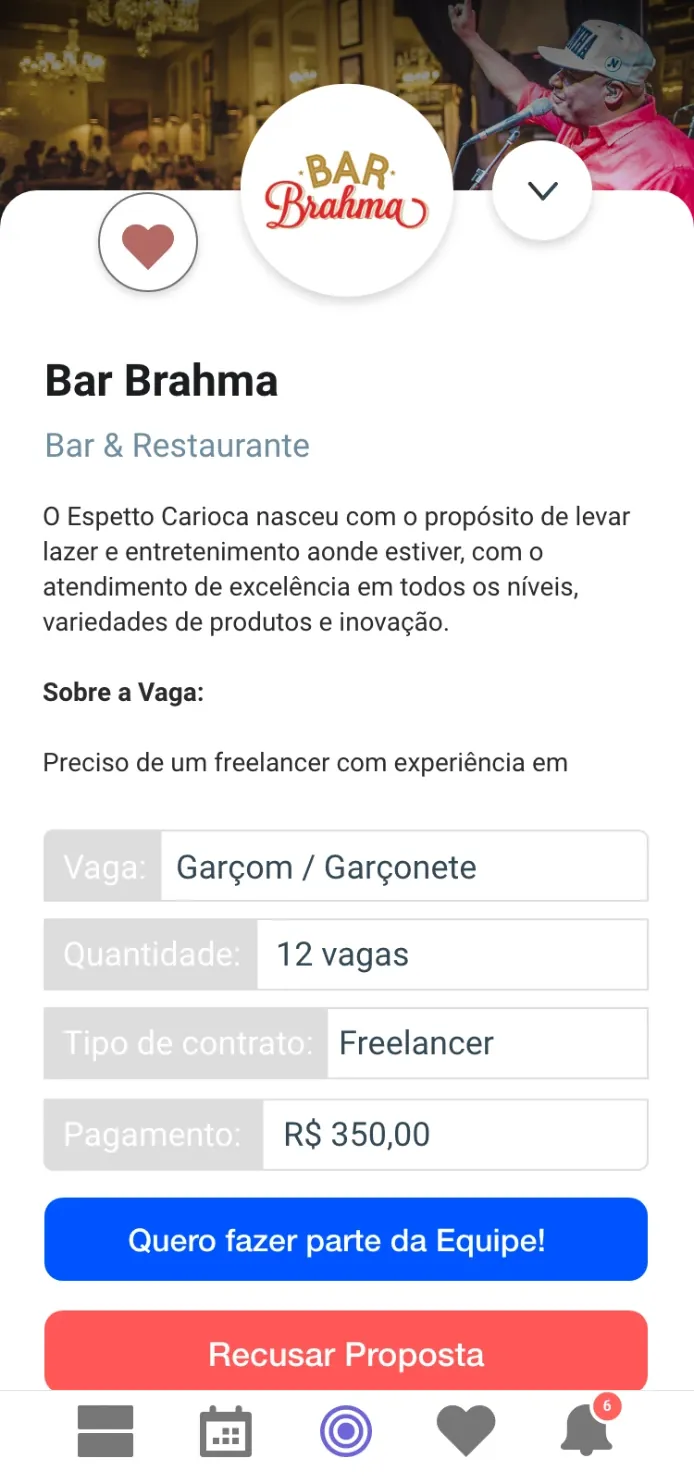
A ideia dos cards não nasceu aqui. Em 2019 e 2020, fui Product Designer da Estaff, uma startup que liga bares e restaurantes a profissionais freelancers. Sentei com os stakeholders para entender o que eles queriam e fiz um brainstorm com o time. O problema era velocidade: muitas vezes o freela surgia para uma vaga que precisava ser preenchida no mesmo dia. Aí um dos sócios perguntou: e o Tinder?
Daí nasceu a mecânica. As vagas apareciam para os profissionais cadastrados em cards, com um resumo que destacava a urgência e o bônus: às vezes, pegar um caso urgente rendia mais dinheiro ao freela. A pessoa lia e decidia se tinha interesse ou não. O bar recebia rápido quem estava disponível, e o profissional conseguia buscar o que queria. O retorno era que lançar uma vaga e conseguir gente para o freela era rápido. Se a empresa gostava do freela, gravava como favorito, e quando abria uma oportunidade, contratava.
Três pesquisas ajudam a entender por que deslizar funciona. A lei de Hick, de 1952, mostra que o tempo para decidir cresce com o número de opções: com duas, a decisão sai rápida. Uma análise da NielsenIQ, de 2020, comparou pesquisas de produto respondidas deslizando com as de múltipla escolha e encontrou resultados na mesma direção, só que menos precisos, porque o gesto reduz uma escala de cinco pontos a dois. E um estudo de 2016 sobre o Tinder lembra o custo da velocidade: decidir rápido também despersonaliza, e a escolha fica na foto e no resumo.
Hoje há empresas que contam que a plataforma tem muita gente cadastrada e supre muitos serviços, e por isso a consideram ágil e completa. Conhecer a Estaff (abre em nova aba)
O card funcionava para decidir rápido sobre uma vaga. No teste às cegas, a pergunta foi se ele funcionaria para decidir rápido sobre uma proposta de governo.
Um assunto pesado
Plano de governo é documento longo, técnico e cheio de promessa. A primeira versão do teste tinha 38 perguntas, com duas propostas cada, uns 8 minutos na estimativa, e a recompensa só aparecia no final. A especificação do projeto chamava isso de “o ponto mais frágil do produto”. Na prática, quem foi até o fim levou 10,6 minutos.
Pesquisa tem esse problema de nascença: quem pergunta precisa do dado, e quem responde não ganha nada com isso. O jeito foi dar à pessoa outro motivo para querer responder. Foi aí que o game design entrou.
Ato II · Como
Por que às cegas
Um estudo de 2003, do psicólogo Geoffrey Cohen, mostrou que as pessoas avaliam a mesma política pelo partido que a defende, e não pelo conteúdo. E negam que fizeram isso. Outro estudo, de 2016, acompanhou o cérebro de pessoas lendo argumentos contra as próprias crenças políticas: a amígdala e a ínsula, ligadas à ameaça e à emoção, se ativaram mais em quem resistia a mudar de ideia.
“Com o nome na tela, a pergunta vira: de que lado você está?”
Tirar o nome desarma essa defesa, e a pessoa volta a ler a proposta. O de 2016 tem amostra pequena e mostra correlação, então eu leio como uma direção.
Marionetes numa luta
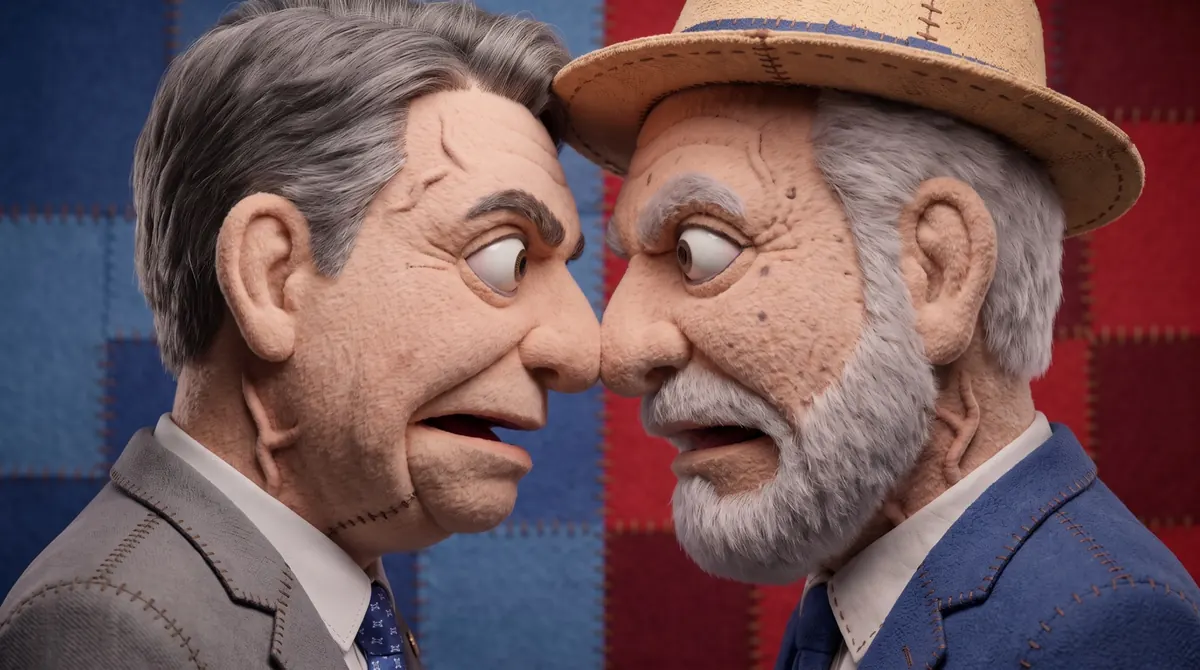
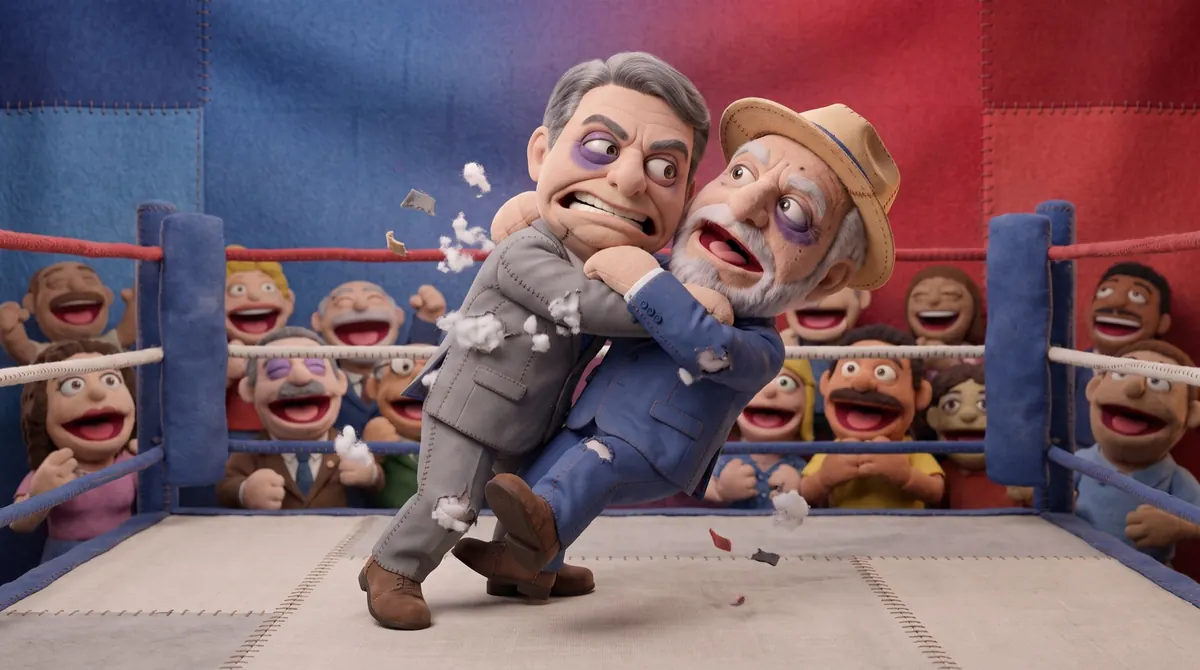
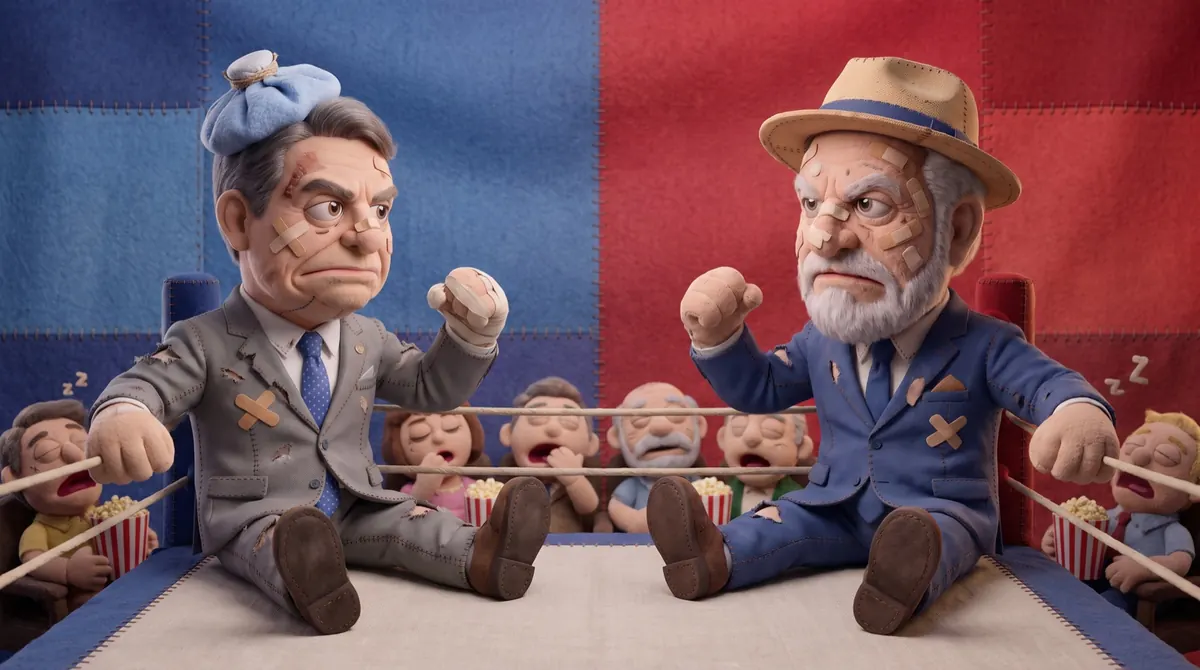
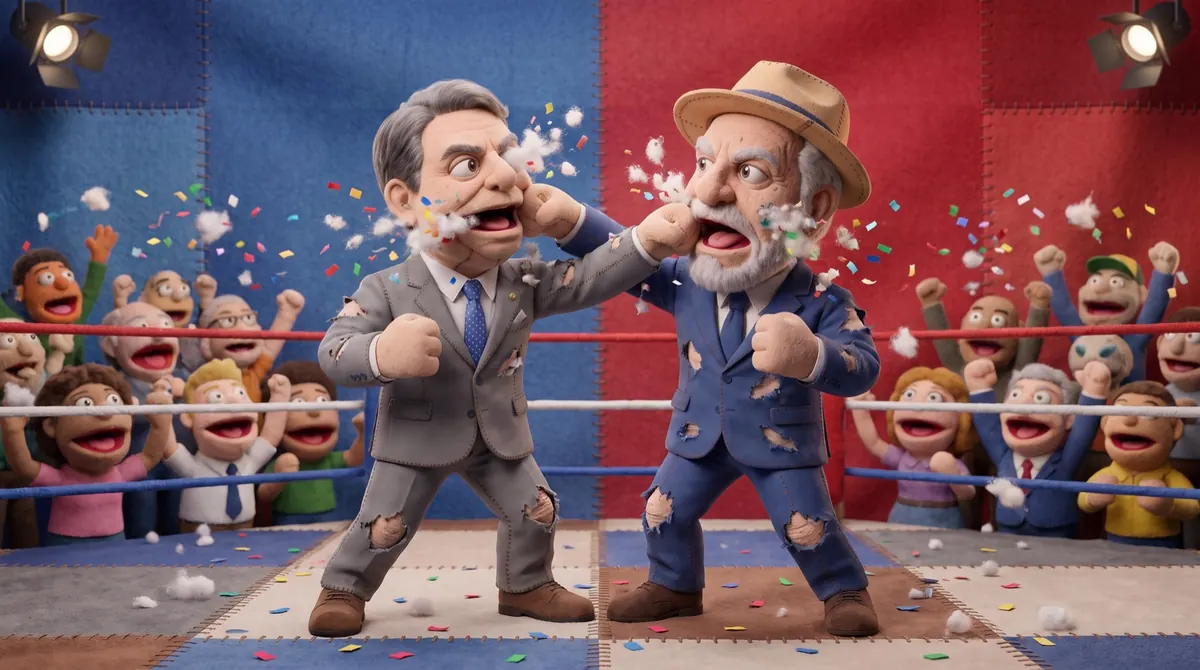
Outra decisão foi o visual. Os candidatos aparecem como marionetes de feltro, numa luta. A marionete abre espaço para o alívio cômico: o assunto continua sério, mas a pesquisa ganha um tom descontraído.
E a luta vira mais um motivo para seguir. Cada card traz uma cena, e as cenas acompanham as faixas: a primeira pergunta abre com os dois de nariz encostado, a luta esquenta no meio, os bonecos chegam amassados perto do fim, e a última pergunta fecha com um golpe cruzado. A pessoa avança também para ver onde essa luta vai parar.
O que puxa e o que empurra
Fui atrás do que a pesquisa diz sobre por que alguém larga uma tarefa no meio e o que faz seguir. Os nomes que aparecem são o circuito de recompensa, a amígdala e a ínsula e o controle executivo. Cada força virou uma decisão do teste.
| Força | O que a pesquisa aponta | Onde aparece no teste |
|---|---|---|
| Curiosidade | A curiosidade ativa o circuito de recompensa antes de a resposta chegar. A pessoa aceita gastar tempo para descobrir a resposta, e o que ela aprende com curiosidade fica mais tempo na memória. Kang et al. (2009) (abre em nova aba), Gruber, Gelman e Ranganath (2014) (abre em nova aba) | O lado só aparece na faixa final. |
| Meta perto | O esforço acelera conforme a recompensa se aproxima, e um pouco de progresso dado de saída aumenta a chance de terminar. Kivetz, Urminsky e Zheng (2006) (abre em nova aba), Nunes e Drèze (2006) (abre em nova aba) | As faixas, a jornada com o "comece aqui" e o "só falta a final". |
| Autonomia | A motivação que nasce de escolha própria se sustenta mais que a controlada de fora. Ryan e Deci (2000) (abre em nova aba) | Parar é de graça, os dois botões têm o mesmo peso e a pessoa escolhe o modo. |
| Força | O que a pesquisa aponta | Onde aparece no teste |
|---|---|---|
| Custo do esforço | A sensação de esforço funciona como aviso de que há coisa melhor para fazer, e empurra a pessoa a trocar de tarefa. Kurzban, Duckworth, Kable e Myers (2013) (abre em nova aba) | O Light como padrão: 5,6 minutos contra 10,6 do Completo. |
| Questionário longo | Quanto maior a duração anunciada, menos gente começa, e no fim as respostas ficam mais apressadas e parecidas. Galesic e Bosnjak (2009) (abre em nova aba) | Faixas curtas, de uns 2 minutos cada. |
| Resposta boa o bastante | Cansada, a pessoa passa a dar a primeira resposta aceitável em vez da que pensaria com calma. Krosnick (1991) (abre em nova aba) | Cards rápidos, um gesto por proposta, e o "não sei" como saída honesta. |
| Defesa da identidade | A mesma política é avaliada pelo partido que a defende, não pelo conteúdo. Quando a crença política é desafiada, a amígdala e a ínsula se ativam. Cohen (2003) (abre em nova aba), Kaplan, Gimbel e Harris (2016) (abre em nova aba) | Às cegas: sem o nome, a ideia é que a defesa não ligue e a pessoa leia a proposta. |
Tem um cuidado aqui. Tudo isso dá para usar para prender a pessoa à força, e o teste foi desenhado para o contrário: parar é de graça, os dois botões têm o mesmo peso, não tem contagem regressiva nem “você vai perder”, e o lado escondido até o fim é avisado desde a capa.
Pesquisa em fases
Em pesquisa, quem para no meio costuma virar dado jogado fora. No teste, cada faixa grava as respostas quando termina, e o sorteio espalha as perguntas de cada tema por faixas diferentes. Assim, quem para na primeira faixa já deixa um retrato de vários temas, e não de dois ou três.
As faixas foram pensadas para motivar e cobrir os temas, e não com uma pergunta de pesquisa por etapa. Hoje eu desenharia começando por aí: o que cada fase precisa entregar para quem pesquisa, e o que ela valida.
| Fase | O que entrega para quem pesquisa | O que valida ou direciona |
|---|---|---|
| Primeira faixa | Um retrato largo e raso: vários temas, poucas perguntas | Se a mecânica foi entendida e se o assunto prende. É aqui o maior corte |
| Faixas do meio | Profundidade: mais de um ponto por tema | A consistência da pessoa (o Teimosômetro, o Tanto Faz) |
| Faixa final | O quadro completo e a revelação | A afinidade, com o resultado mais firme |
| Light | As 19 perguntas que mais separam os lados | Para que lado a pessoa pende, com pouco custo |
| Completo | As 38 perguntas | Em que temas ela diverge do próprio lado |
E o A/B entre Light e Completo só faz sentido depois disso. Antes de comparar duas versões, é preciso saber o que cada uma entrega.
E teve um erro meu nessa parte. Para tentar aumentar o número de gente que concluía todas as faixas, coloquei na tela de parada uma parcial: para que lado a pessoa pendia até ali. Nas gravações do Clarity, vi dois casos de gente que terminou a primeira faixa, viu que pendia para um dos candidatos e saiu da página.
São só dois casos, então fico com duas hipóteses. Ou a pessoa não gostou de ver afinidade com aquele candidato logo no começo, e a defesa da identidade falou mais alto. Ou ela só queria matar a curiosidade, e a parcial entregou a resposta antes da hora: sem o lado escondido, acabou o motivo para seguir. Se a parcial ajudou ou atrapalhou no geral, eu não sei: ela entrou no ar uma hora antes da primeira resposta, então não existe um antes para comparar. Para medir de verdade, ela teria que ter entrado como um A/B. Fica a lição: o que aparece entre uma fase e outra decide se a pessoa continua, e mexer nisso pede teste.
O tutorial
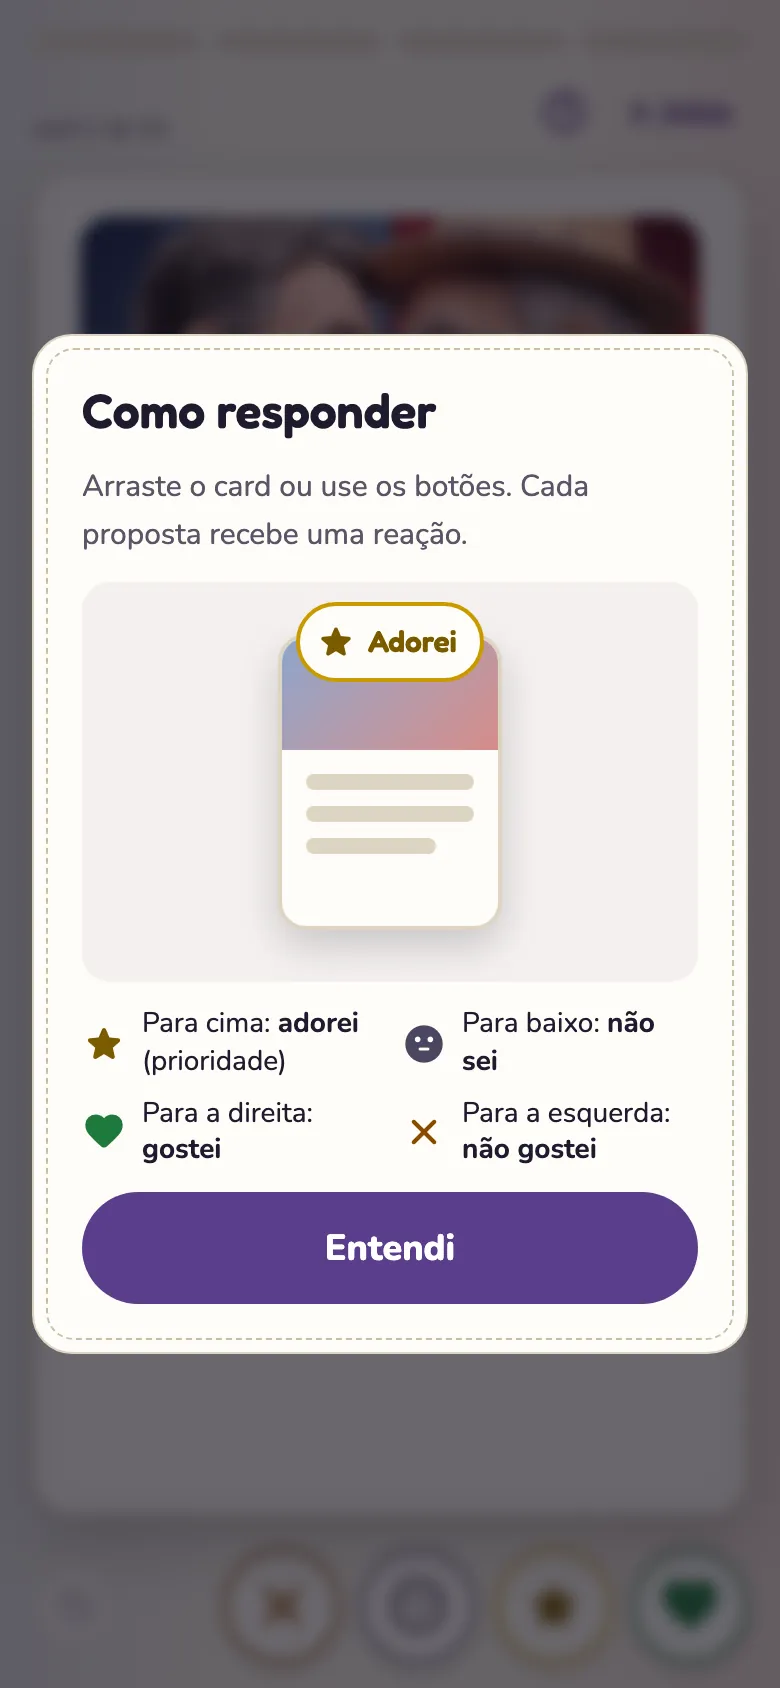
O teste se inspirou no Tinder, mas tem quatro gestos, não dois: direita é gostei, esquerda é não gostei, cima é adorei e baixo é não sei. Por isso precisou de um tutorial rápido.
No começo, ele mostrava primeiro direita e esquerda, e depois cima e baixo. As gravações do Clarity mostraram o que acontecia: a pessoa reconhecia o gesto do Tinder, fechava o popup e seguia só com direita e esquerda. O gesto conhecido atropelava a explicação.
Invertemos a ordem. Com cima e baixo primeiro, a pessoa via o gesto novo e esperava para ver se vinha o conhecido. Rodamos um A/B das duas ordens e, no dia seguinte, cima e baixo primeiro virou o padrão para todos.
No Light, 3 de 7 pessoas concluíram com a ordem antiga e 4 de 5 com a nova. A diferença aponta para o mesmo lado, mas com 12 pessoas não prova nada. Quem decidiu foi o comportamento gravado, antes de o número ter peso.
A NielsenIQ viu algo parecido na mesma análise: só metade das pessoas completou certo o exercício de prática, e o deslizar soa natural para quem usa app de namoro, mas bem menos para quem tem mais de 55 anos. O gesto parece óbvio, e ainda assim precisa ser ensinado.
A ordem do tutorial, antes e depois
- 1 Gostei, para a direita
- 2 Não gostei, para a esquerda
- 3 Adorei, para cima
- 4 Não sei, para baixo
- 1 Adorei, para cima
- 2 Não sei, para baixo
- 3 Gostei, para a direita
- 4 Não gostei, para a esquerda
As telas do teste
Light e Completo
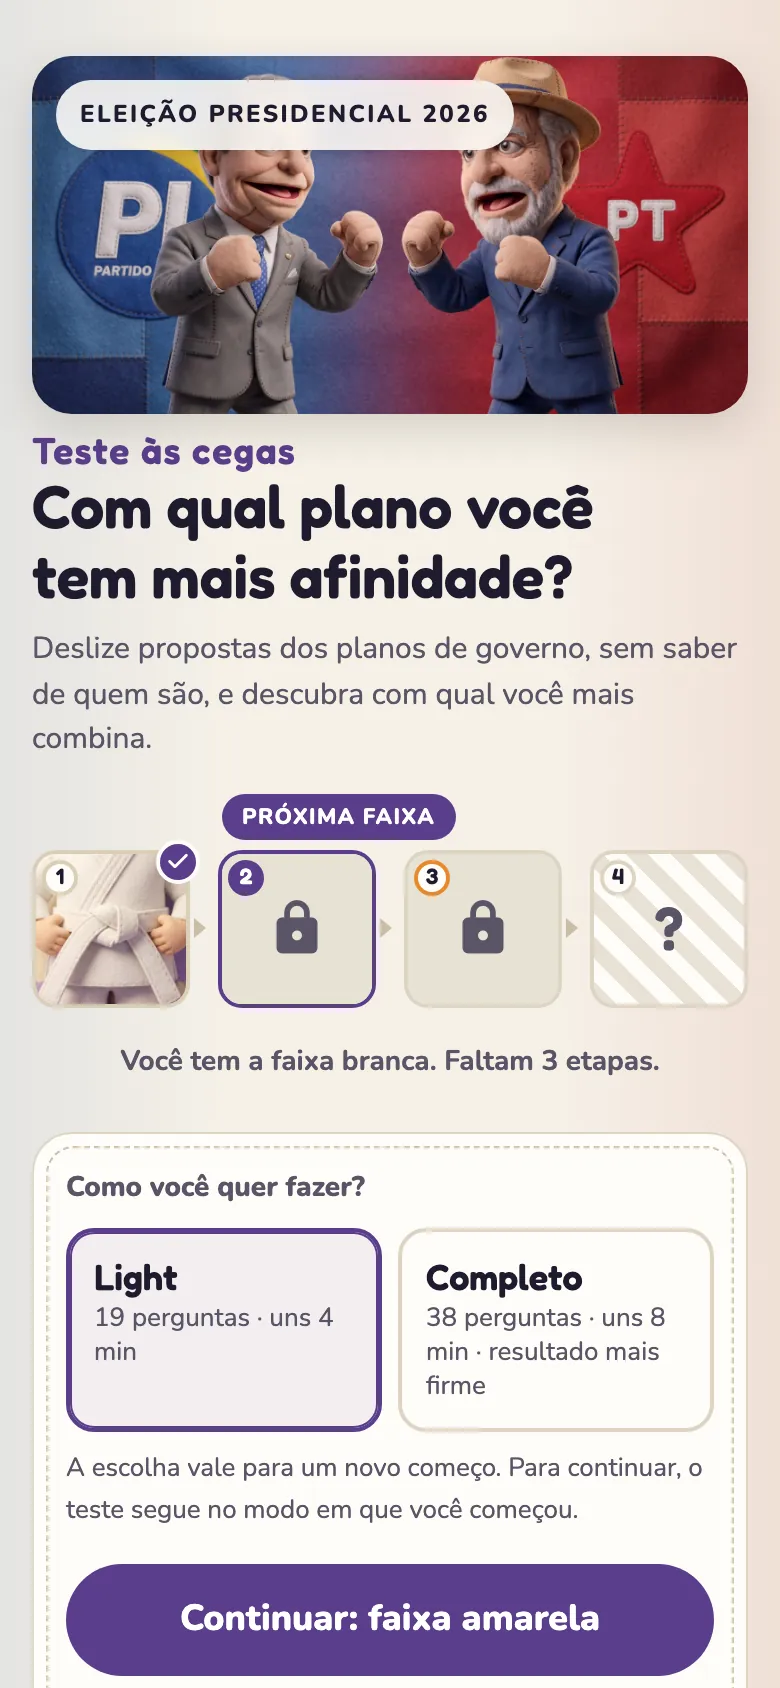
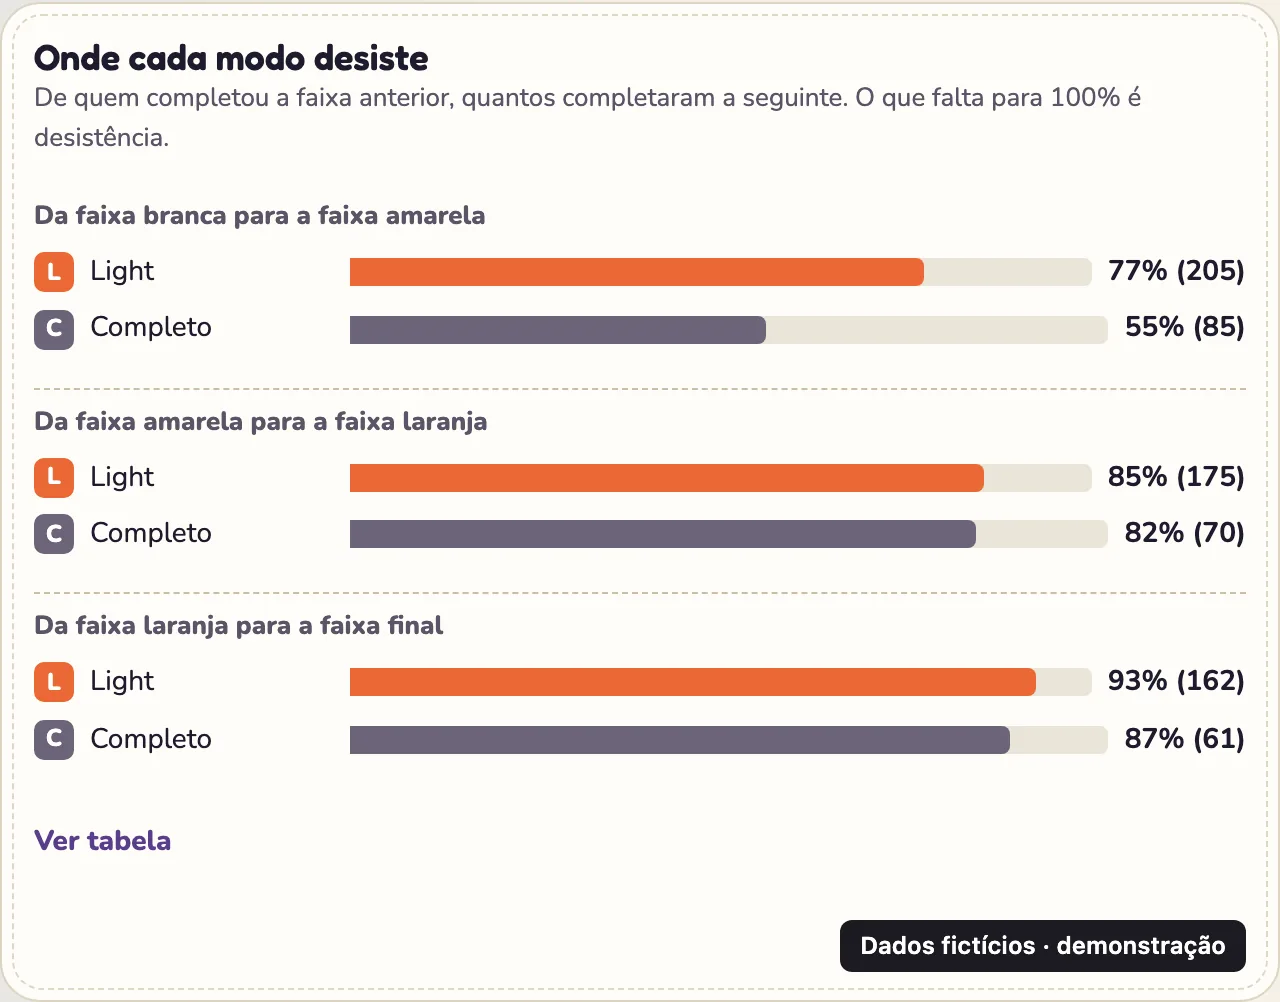
O Completo tinha 38 perguntas e perdia gente demais: mais da metade parava logo na primeira faixa. Para testar, criamos uma versão com 19, as que mais separam os dois planos, e sorteamos quem caía em cada uma.
Só que as eleições estavam acabando, e não dava para esperar o sorteio fechar uma resposta. A decisão foi rápida: o Light virou o padrão, com o Completo como opção na capa, e quem terminava o Light podia fazer uma rodada bônus com as outras 19.
Isso teve um custo, e ficou registrado no próprio projeto: quando a pessoa escolhe, a comparação entre Light e Completo deixa de mostrar causa, porque quem escolhe o Completo já é diferente de quem fica no Light. Pesquisa em produto real tem prazo, e às vezes a decisão vem antes da prova.
| Light | 50% (7 de 14) |
|---|---|
| Completo | 40% (6 de 15) |
Fonte: Base de respostas do teste, sem as respostas de teste
| Light | 5,6 min |
|---|---|
| Completo | 10,6 min |
Fonte: Base de respostas do teste
| Completo | Light | Total | |
|---|---|---|---|
| Responderam ao menos a primeira faixa | 15 | 14 | 29 |
| Pararam na primeira faixa (branca) | 8 (53%) | 5 (36%) | 13 |
| Concluíram | 6 (40%) | 7 (50%) | 13 |
| Tempo de quem concluiu (mediana) | 10,6 min | 5,6 min |
Ato III · O que os números dizem
O funil
Divulguei o teste num post no Instagram e no LinkedIn e numa mensagem num grupo de WhatsApp. Do post até o fim, o caminho foi esse:
- de quem viu os posts no Instagram e no LinkedIn abriu o teste
- 8,1%
- de quem abriu o teste passou da primeira faixa
- 51%
- de quem passou da primeira faixa foi até o fim
- 45%
Fonte: Microsoft Clarity e a base de respostas do teste, sem as respostas de teste
| Etapa | Pessoas | Da etapa anterior |
|---|---|---|
| Visualizações dos posts (Instagram e LinkedIn) | 272 | |
| Abriram o teste (usuários únicos no Clarity) | cerca de 57 | 21% |
| Responderam ao menos a primeira faixa | 29 | 51% |
| Concluíram | 13 | 45% |
O maior corte vem antes da primeira faixa: das cerca de 57 pessoas que abriram o teste, 28 saíram sem terminar nem a primeira parte. É ali que ficam a capa, a escolha do modo e o tutorial. Depois da primeira faixa, quase metade vai até o fim.
Para comparar: uma meta-análise de 2015 sobre pesquisas no celular cita um levantamento com 68% a 84% de abandono no celular, contra 17% a 23% no computador. O teste ficou na faixa do celular, com 13 conclusões entre cerca de 57 pessoas que abriram. Ou seja, o piloto não prova que esse formato segura mais gente que uma pesquisa comum. Ele mostra onde a gente perde, e isso bate com o que a mesma meta-análise registra: a maior parte dos abandonos acontece logo na primeira tela.
| WhatsApp (um grupo) | 29 |
|---|---|
| 13 | |
| 9 | |
| Diretas | 6 |
Fonte: Microsoft Clarity
O grupo de WhatsApp trouxe mais gente que os dois posts juntos. Os posts tiveram 272 visualizações e trouxeram 22 pessoas, 8,1%. Uma mensagem pessoal, num grupo de gente que me conhece, pesou mais que um post para seguidores. E, nos acessos em que o Clarity registrou o aparelho, quase metade veio do celular.
O painel
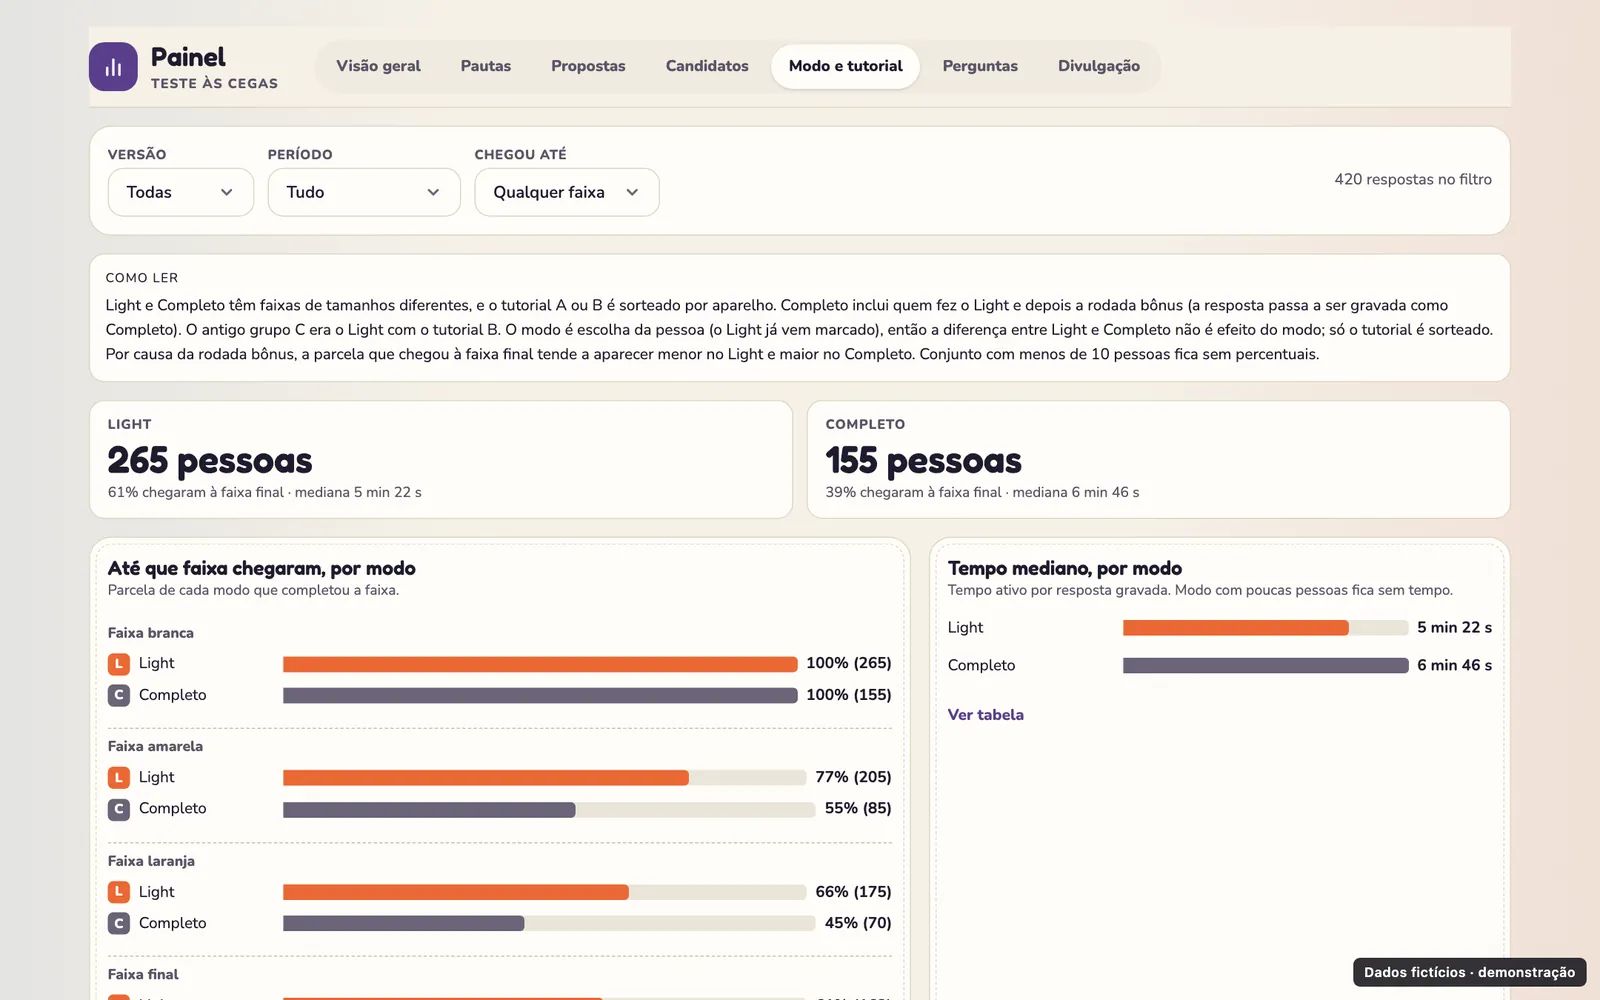
Para ler os dados, montei com IA um painel no estilo BI, só para mim. Ele se atualiza em tempo real: cada faixa concluída chega à base e aparece no painel na hora, sem recarregar a página. Dá para acompanhar a pesquisa enquanto ela acontece, e acompanhar o efeito de uma mudança, como a ordem do tutorial, sem esperar a pesquisa terminar.
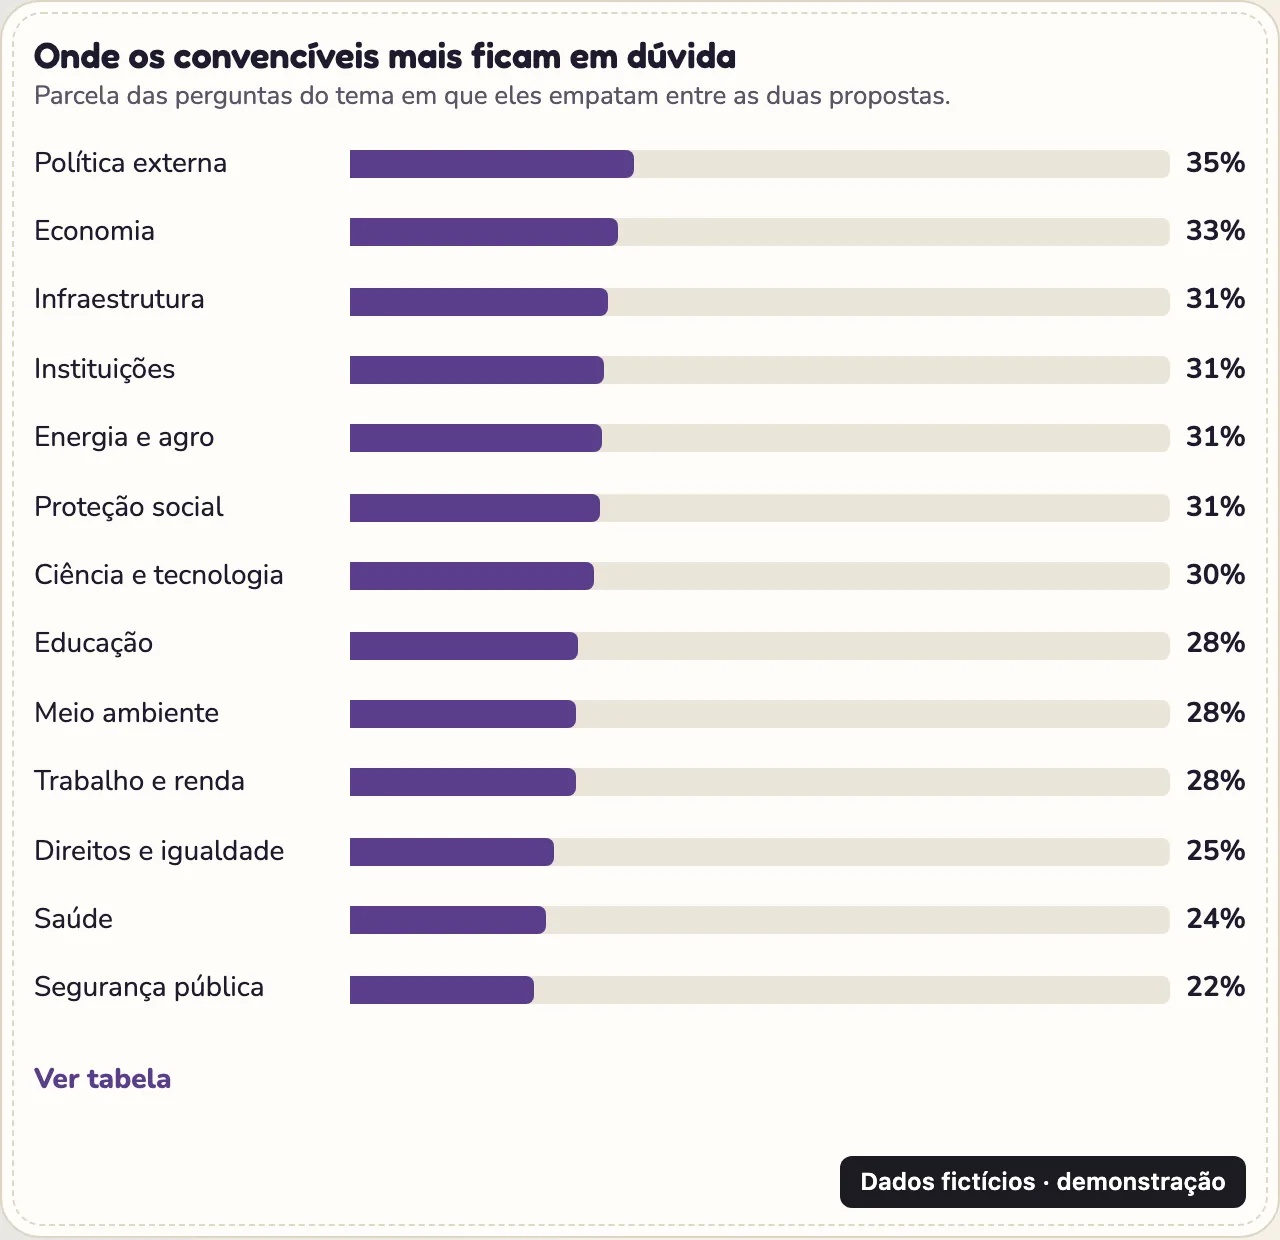
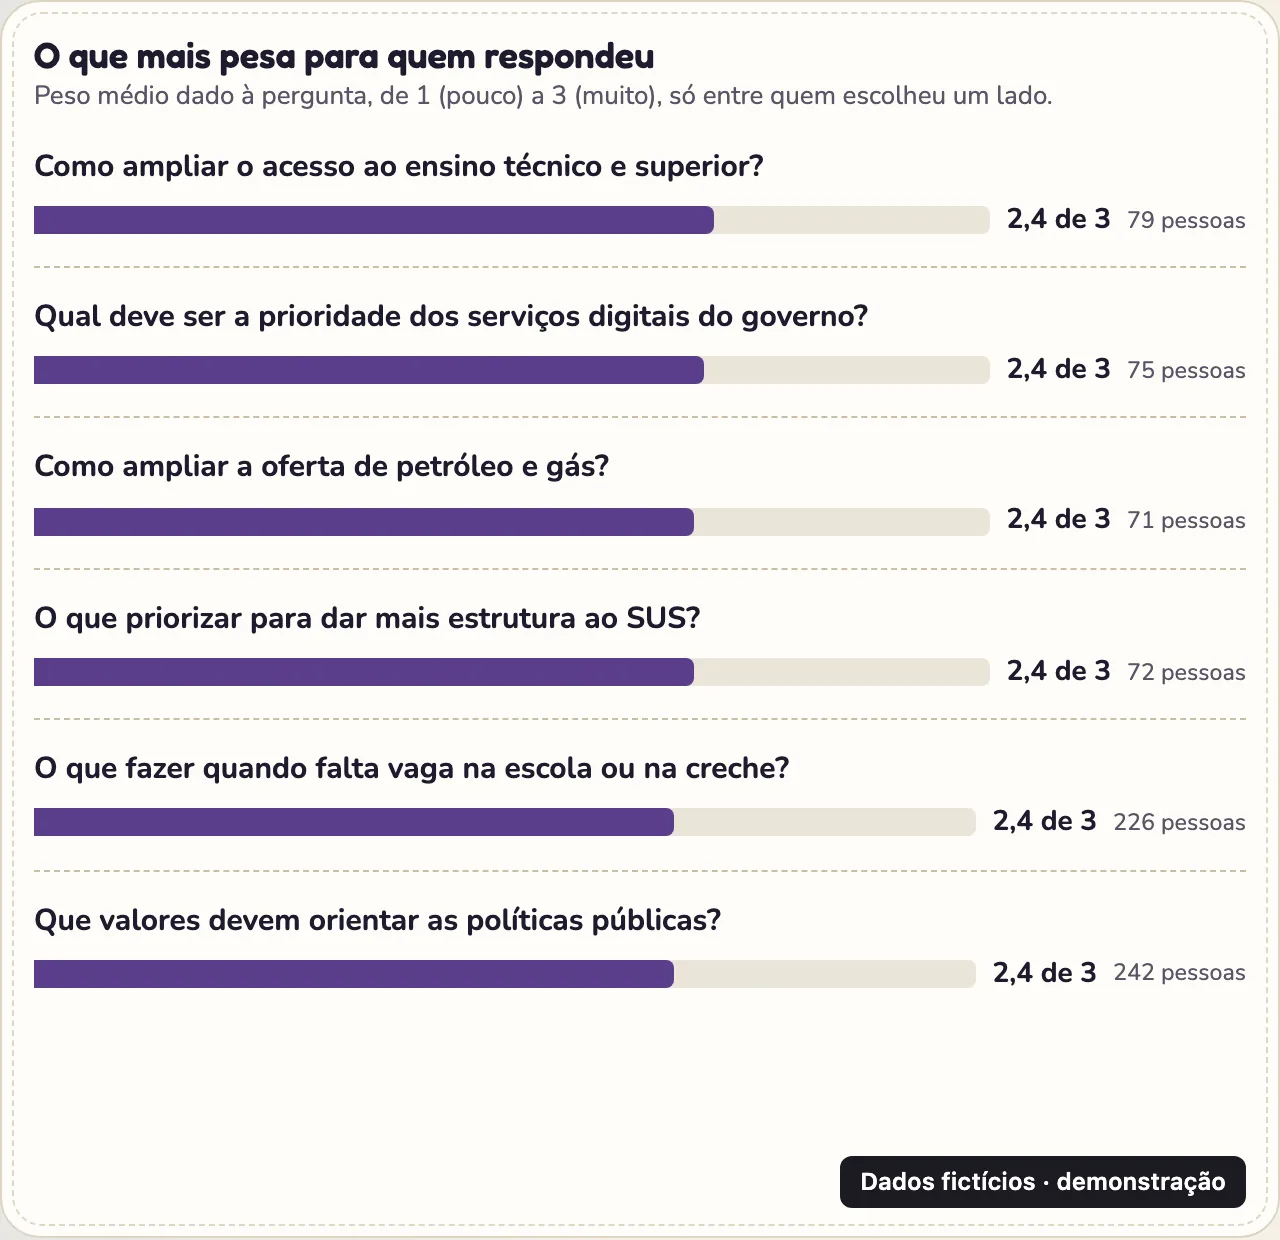
O que uma empresa quer de uma pesquisa raramente é o número sozinho. Ela quer saber o que fazer com ele. Por isso, cada página do painel responde a uma pergunta de decisão. A Visão geral mostra quem respondeu e até onde foi. Pautas mostra em que temas as bases discordam e onde quem está em dúvida fica dividido. Propostas mostra o que cada proposta ganha ou perde. Candidatos traz quatro listas: o que reforçar com a base, o que conquista indecisos, o que defender ou reformular e onde o rival está fraco.
Os filtros valem para o painel inteiro: versão, modo, tutorial, período e até que faixa a pessoa chegou. Clicar num pedaço do gráfico também filtra tudo. A leitura começa larga e vai afunilando até a pergunta de quem decide.
E o painel protege a própria leitura. Grupo com menos de 30 pessoas aparece sem porcentagem, o aviso de que a amostra é autosselecionada fica fixo no topo, e os resultados reunidos só seriam divulgados depois das eleições, por liberação manual.
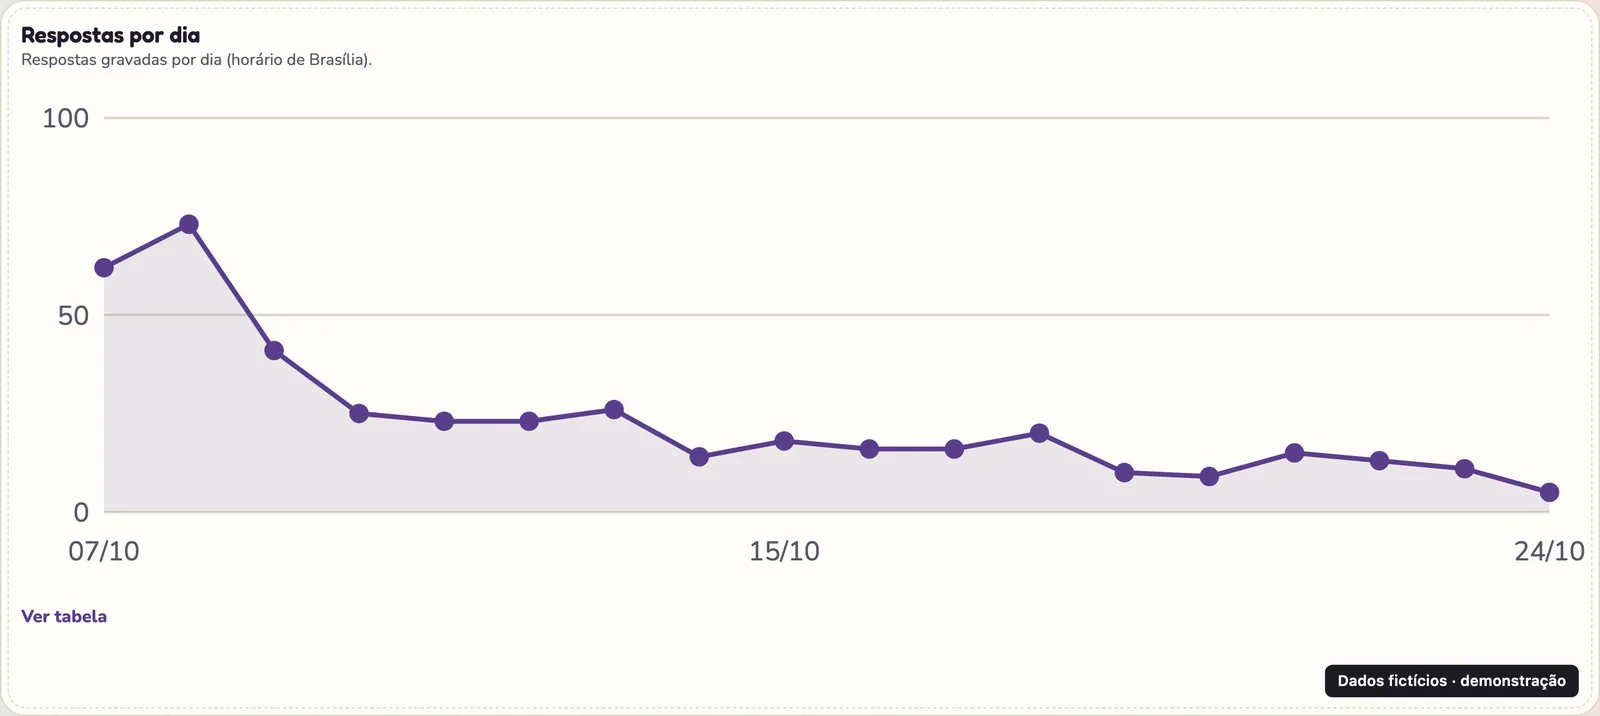
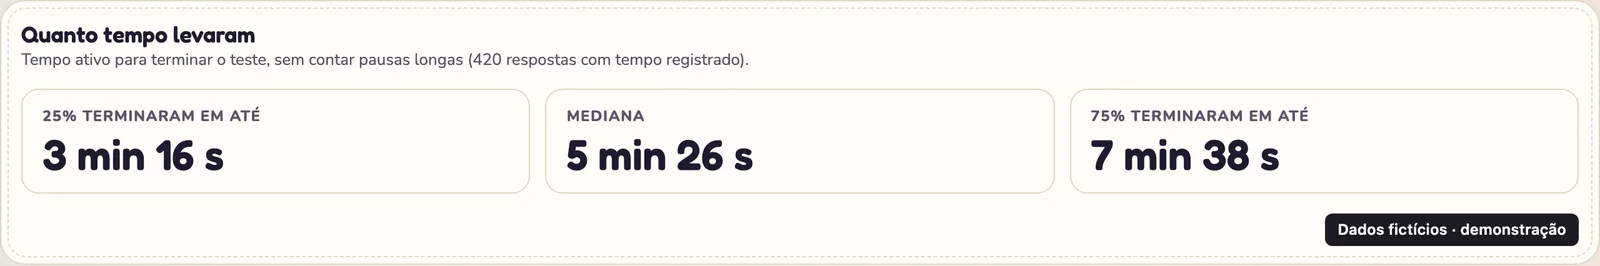
As imagens aqui são de uma versão de demonstração, com respostas fictícias, porque o painel de verdade também mostra os resultados políticos, e esses ficam fora deste estudo.
Outros recortes do painel
Os limites
Era um piloto, e os números têm o tamanho de um piloto. A amostra é pequena e autosselecionada: respondeu quem quis, a partir de quem me segue. O teste não é pesquisa eleitoral e não mede intenção de voto.
Só entra na base quem deixou o aceite marcado e terminou a primeira faixa; quem largou antes só aparece no Clarity. Os acessos ao teste podem incluir alguns meus, enquanto eu testava. E a base não guarda de onde veio cada resposta, então não dá para saber qual canal concluiu mais.
A provocação que fica
Para quem respondeu, fica uma provocação. O que acontece com a pessoa que faz o teste e descobre que tem mais afinidade com o plano do candidato adversário? E com quem percebe que concorda com propostas dos dois lados?
O teste não mede isso, e essa resposta eu não tenho. Mas a pergunta continua aberta:
“Um teste que engaja, diverte e dá conhecimento público ajuda a enriquecer o debate político da população?”
O que fica
Era um piloto, e ele respondeu às duas perguntas do começo. O formato engaja o suficiente para valer um teste maior, e o lugar onde ele perde gente está claro: a capa, a escolha do modo e o tutorial, antes da primeira faixa. Quem passou dela tendeu a ir até o fim.
Duas lições ficam para qualquer pesquisa. O que a pessoa já conhece atropela o que você quer ensinar, então comece pelo que ela não conhece. E tudo o que aparece entre uma fase e outra mexe na decisão de continuar, então entra com teste, não com palpite.
“A pesquisa que a pessoa quer terminar começa antes da primeira pergunta.”
Sobre a IA em UX Research: da pergunta ao teste no ar, com painel e medição, foram três dias. O próximo passo é levar o formato a um público maior.
Bastidores
A segunda pergunta do piloto era o que a IA abre para UX Research. Ela entrou em cada parte: resumir os planos em propostas, construir o teste e o painel, gerar as ilustrações e ler os dados. Com isso, deu para ir da pergunta a um teste no ar, com gente de verdade respondendo e com medição, e ter dado para decidir se o formato vale crescer.
Fiz o teste em três dias, de 6 a 8 de outubro de 2026, com o Claude escrevendo o código comigo e a API do Magnific gerando as ilustrações de feltro. As propostas foram resumidas por IA a partir dos planos oficiais e conferidas contra os textos originais. Foram 165 commits, entre o teste, o painel e os ajustes que as gravações pediram.
Fontes
- Kang et al. (2009). The Wick in the Candle of Learning: Epistemic Curiosity Activates Reward Circuitry and Enhances Memory. Psychological Science. (abre em nova aba)
- Gruber, Gelman e Ranganath (2014). States of Curiosity Modulate Hippocampus-Dependent Learning via the Dopaminergic Circuit. Neuron. (abre em nova aba)
- Kivetz, Urminsky e Zheng (2006). The Goal-Gradient Hypothesis Resurrected. Journal of Marketing Research. (abre em nova aba)
- Nunes e Drèze (2006). The Endowed Progress Effect: How Artificial Advancement Increases Effort. Journal of Consumer Research. (abre em nova aba)
- Ryan e Deci (2000). Self-Determination Theory and the Facilitation of Intrinsic Motivation, Social Development, and Well-Being. American Psychologist. (abre em nova aba)
- Kurzban, Duckworth, Kable e Myers (2013). An Opportunity Cost Model of Subjective Effort and Task Performance. Behavioral and Brain Sciences. (abre em nova aba)
- Galesic e Bosnjak (2009). Effects of Questionnaire Length on Participation and Indicators of Response Quality in a Web Survey. Public Opinion Quarterly. (abre em nova aba)
- Krosnick (1991). Response Strategies for Coping with the Cognitive Demands of Attitude Measures in Surveys. Applied Cognitive Psychology. (abre em nova aba)
- Cohen (2003). Party Over Policy: The Dominating Impact of Group Influence on Political Beliefs. Journal of Personality and Social Psychology. (abre em nova aba)
- Kaplan, Gimbel e Harris (2016). Neural Correlates of Maintaining One's Political Beliefs in the Face of Counterevidence. Scientific Reports. (abre em nova aba)
- Hick (1952). On the Rate of Gain of Information. Quarterly Journal of Experimental Psychology. (abre em nova aba)
- NielsenIQ (2020). Do Device Swipes Deliver a Perfect Match for Innovation Testing? (abre em nova aba)
- David e Cambre (2016). Screened Intimacies: Tinder and the Swipe Logic. Social Media + Society. (abre em nova aba)
- Mavletova e Couper (2015). A Meta-Analysis of Breakoff Rates in Mobile Web Surveys. Em Mobile Research Methods, Ubiquity Press. (abre em nova aba)